


- share :
AI半導体と聞いて、まずNVIDIA(エヌビディア)を思い浮かべる人は多いでしょう。NVIDIAは、GAFAMの次世代覇権となるMATANA、そしてDXportal®編集部が注目したMANGOにも名をつられた企業ですが、生成AIの学習にも推論にも、NVIDIAのGPUが使われているという報道を、この数年で何度も目にしてきたはずです。株式市場でも、NVIDIAは世界最大級の時価総額を持つ企業として名前が挙がり続けています。
とはいえ、そのNVIDIAのGPUは、NVIDIAだけでは作れません。
NVIDIAは自社で工場を持たず、設計に専念するファブレス企業です。実際に半導体を製造しているのは台湾のTSMCであり、TSMCが最先端の回路を焼き付けるには、オランダのASMLが作る露光装置が必要になります。GPUの性能を引き出すには、SK hynixやSamsung Electronicsが作るHBM(広帯域メモリ)が必要ですし、シリコンウエハーという素材を作るのは、日本の信越化学工業やSUMCOです。そして完成した半導体が正しく動くかを最後に確かめるのは、Advantestのようなテスト専業企業になります。
設計、製造、露光、装置、メモリ、材料、パッケージング、検査。AI半導体は、これだけ多くの企業がそれぞれの持ち場を守ることで、はじめて1個のチップとして完成します。この構造を知っておくと、自社でAIをどのクラウドで、どれだけのコストで使えるかという判断にも、遠くつながってきます。GPUの供給逼迫や価格動向は、巡り巡って企業が支払うAI利用料にも影響するからです。
本記事が問いたいのは、この構造を踏まえたうえでの、もう1段深い疑問です。NVIDIA一強に見える現在、本当にAI半導体の覇権を握っているのはどこなのでしょうか。一番売上の大きな企業なのか、それとも、代わりが利かない場所を押さえている企業なのか。順番に見ていきます。
【本記事の要点】
- AI半導体の代名詞であるNVIDIAも、設計に特化したファブレス企業であり、製造・装置・メモリ・材料・検査を担う多数の企業なしには1個のチップを完成させられない
- AI半導体サプライチェーンには、TSMC(製造)、ASML(露光装置)、SK hynix(HBM)、東京エレクトロン(製造装置)、Advantest(テスト)など、それぞれ異なる「喉元」を握る企業が併存する
- 覇権を測る軸は売上規模だけでなく、技術力・代替困難性・ボトルネック支配という複数の視点で見る必要がある
- 日本企業は完成品の市場占有率でこそ目立たないが、半導体を作るための装置・材料の領域で世界のサプライチェーンを支えている
なぜAI半導体市場はNVIDIA一強に見えるのか
まず、NVIDIAの現在地を数字で確認しておきましょう。2026年7月26日に終了した四半期の決算で、NVIDIAは売上高962億ドルを計上しました。前年同期比で106%の増加です。このうち、AIデータセンター向け事業の売上高は890億ドルで、前年同期比117%増となっています。売上高の9割前後をデータセンター事業が占める構造は、ここ数年変わっていません。
この規模を支えているのが、AI向けGPU市場での高いシェアです。市場調査会社の推計では、NVIDIAはAIアクセラレータ市場の8割台半ばから9割近いシェアを持つとされます。ただし、同じ調査では、AMDのInstinctシリーズや大手クラウド企業の自社開発チップの台頭により、2026年末にかけてこのシェアが7割台まで下がる可能性も指摘されています。
NVIDIAの強さは、GPUという半導体そのものだけでは説明がつきません。創業者兼CEOのジェンスン・フアン氏(Jensen Huang)が長年かけて作り上げてきたのは、CUDAと呼ばれるソフトウェア開発環境を中心としたエコシステムです。
CUDAは、NVIDIAのGPUで並列計算を行うためのプログラミング環境で、AIモデルの学習用ライブラリや開発ツール、教育プログラムまでを含みます。世界中の研究者・エンジニアが学生時代からCUDAに慣れ親しみ、企業もCUDAを前提にAI基盤を構築してきたことで、他社のチップへ乗り換えるコスト(スイッチングコスト)が非常に高くなっています。同社がこれまで公表してきた開発者数は500万人を超える規模に達しており、これがGPUという「ハードウェア」だけでは説明できない参入障壁を作っているのです。
さらにNVIDIAは、単体のGPUチップの販売にとどまらず、GPUを大量に積んだサーバーラックや、データセンター全体の設計指針までを提供する「ラックスケール」戦略を進めています。GPU、ネットワーク、ソフトウェアを一体で売ることで、他社が部分的に優れたチップを出しても、NVIDIAのシステム全体を置き換える難易度をさらに引き上げているのです。
ここまで見ると、NVIDIAがAI半導体市場を1社で制しているように映ります。しかし、これらの数字とエコシステムは、すべてNVIDIAが「設計」した結果にすぎません。では、NVIDIAは本当に一社ですべてを握っているのでしょうか。
出典・参照:
NVIDIAの裏側にある巨大な半導体分業構造
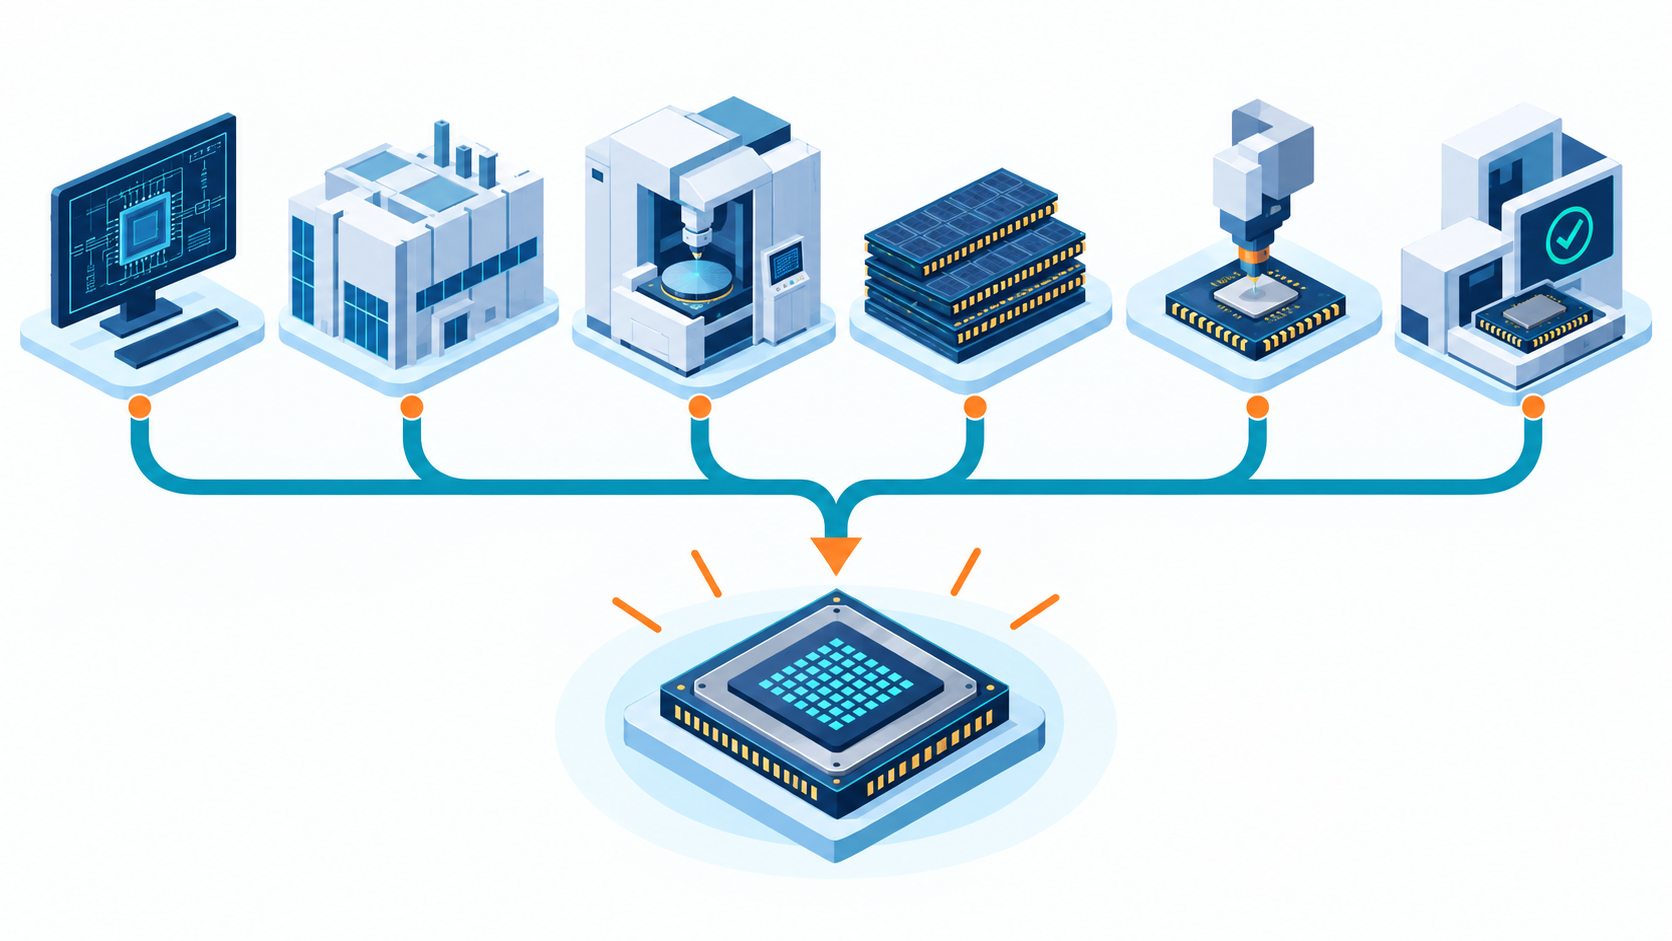
NVIDIAは、自社で半導体工場を持たない「ファブレス」企業です。どれほど優れたGPUを設計しても、それを実際にシリコンの上へ焼き付けて製品にする工程は、すべて他社に委ねています。AI半導体は、設計・製造・装置・メモリ・材料・パッケージング・検査という異なる専門領域を持つ企業が連携して、はじめて1個の完成品になるのです。
そこで本章では、半導体・計算資源部門のノミネート企業を決める上で欠かせない要素とキーとなる企業を、それぞれのレイヤー別に整理して見ていきましょう。
設計:誰が「頭脳の形」を決めるか
半導体・アクセラレータ設計は、GPUやCPU、AI専用に作られたカスタムASIC(特定の用途に最適化した集積回路)の回路そのものを考える工程です。
NVIDIAはGPU設計の代表格ですが、AMDも同様にGPUとCPUの両方を設計し、Broadcomは大手クラウド企業向けのカスタムAIチップを設計します。Armは自ら量産こそしないものの、CPUの基本設計(アーキテクチャ)を提供し、世界中の半導体メーカーがそのライセンスを使って自社チップを作ります。
つまり、どれだけ優れた設計図を描けても、それを実際に作れる工場がなければ製品にはならないという構造があるのです。
最先端製造:設計図をシリコンに焼き付ける
設計された回路を、実際にシリコンウエハーの上へ焼き付ける工程が製造です。
最先端のAI半導体を量産できる企業は世界でも数社に限られており、TSMCとSamsung Electronicsがその代表格です。回路の線幅を細くするほど、同じ面積により多くのトランジスタを詰め込めて性能と省電力性が上がりますが、その微細化には数百億ドル単位の設備投資と、後述するASMLの露光装置が必要になります。
製造装置:微細化を可能にする「道具」
半導体の性能を決めるのは、設計だけではありません。実際に回路を刻む製造装置の精度が、そのまま微細化の限界を決めます。
装置のなかでも特に重要なのが露光装置で、オランダのASMLがEUV(極端紫外線)という特殊な光を使う装置をほぼ独占的に供給しています。ウエハーへ薄い膜を作る成膜装置、不要な部分を削るエッチング装置、フォトレジスト(感光材)を塗って現像する装置では、東京エレクトロンやApplied Materials、Lam Research、SCREENといった企業が世界シェアの多くを握っています。
AI向けメモリ:GPUの計算に「データを届ける」役割
どれほど計算が速いGPUでも、計算対象のデータを十分な速さで受け渡せなければ性能を発揮できません。この役割を担うのが、HBM(広帯域メモリ)と呼ばれる高速メモリです。
HBMは複数のメモリチップを垂直に積み重ねて接続する構造を持ち、従来のメモリより桁違いに高い帯域(データを転送できる量)を実現します。SK hynixとSamsung Electronics、Micronの3社が、このHBM市場のほぼすべてを分け合っています。
材料:シリコンウエハーという出発点
半導体は、シリコンウエハーと呼ばれる円盤状の基板の上に作られます。この基板の品質が、その後のすべての工程の歩留まり(良品率)を左右するのです。
特に先端ノード向けの高品質ウエハーでは、日本の信越化学工業とSUMCOの存在感が大きく、2社合計で世界シェアの半分前後を占めるとされています。
先端パッケージング:複数のチップを1つにまとめる技術
AI半導体は、1個の巨大なチップだけで完結しません。GPU本体とHBMを、極めて近い距離で高速に接続する先端パッケージング技術が必要になります。その代表がCoWoS(チップ・オン・ウエハー・オン・サブストレート)と呼ばれる、TSMCが提供する技術です。
チップとメモリを積み重ねて配線を短くすることで、データのやり取りを高速化し、消費電力を抑えます。CoWoSの生産能力は、AI半導体全体の供給量を左右するボトルネックとして、たびたび話題になってきました。
検査・テスト:完成品が「正しく動くか」を最後に確かめる
設計・製造・パッケージングを終えても、それだけでは商品になりません。最後に、完成した半導体が仕様どおりに動作するかを検査するテスト工程が必要です。AI・HPC(高性能計算)向けの半導体は回路が複雑なため、テストにかかる時間と精度への要求も高まっています。
この分野では、日本のAdvantestと米国のTeradyneが世界的な地位を占めています。
半導体・計算資源部門のノミネート企業はどこだ?
NVIDIAという1社だけを見ていても、AI半導体市場の実態は理解できないという点です。設計・製造・装置・メモリ・材料・パッケージング・検査という7つのレイヤーそれぞれに、代わりが利きにくい企業が存在します。次章では、この構造のなかで正式ノミネートとした10社を、1社ずつ見ていきます。
正式ノミネート10社が握る「喉元」
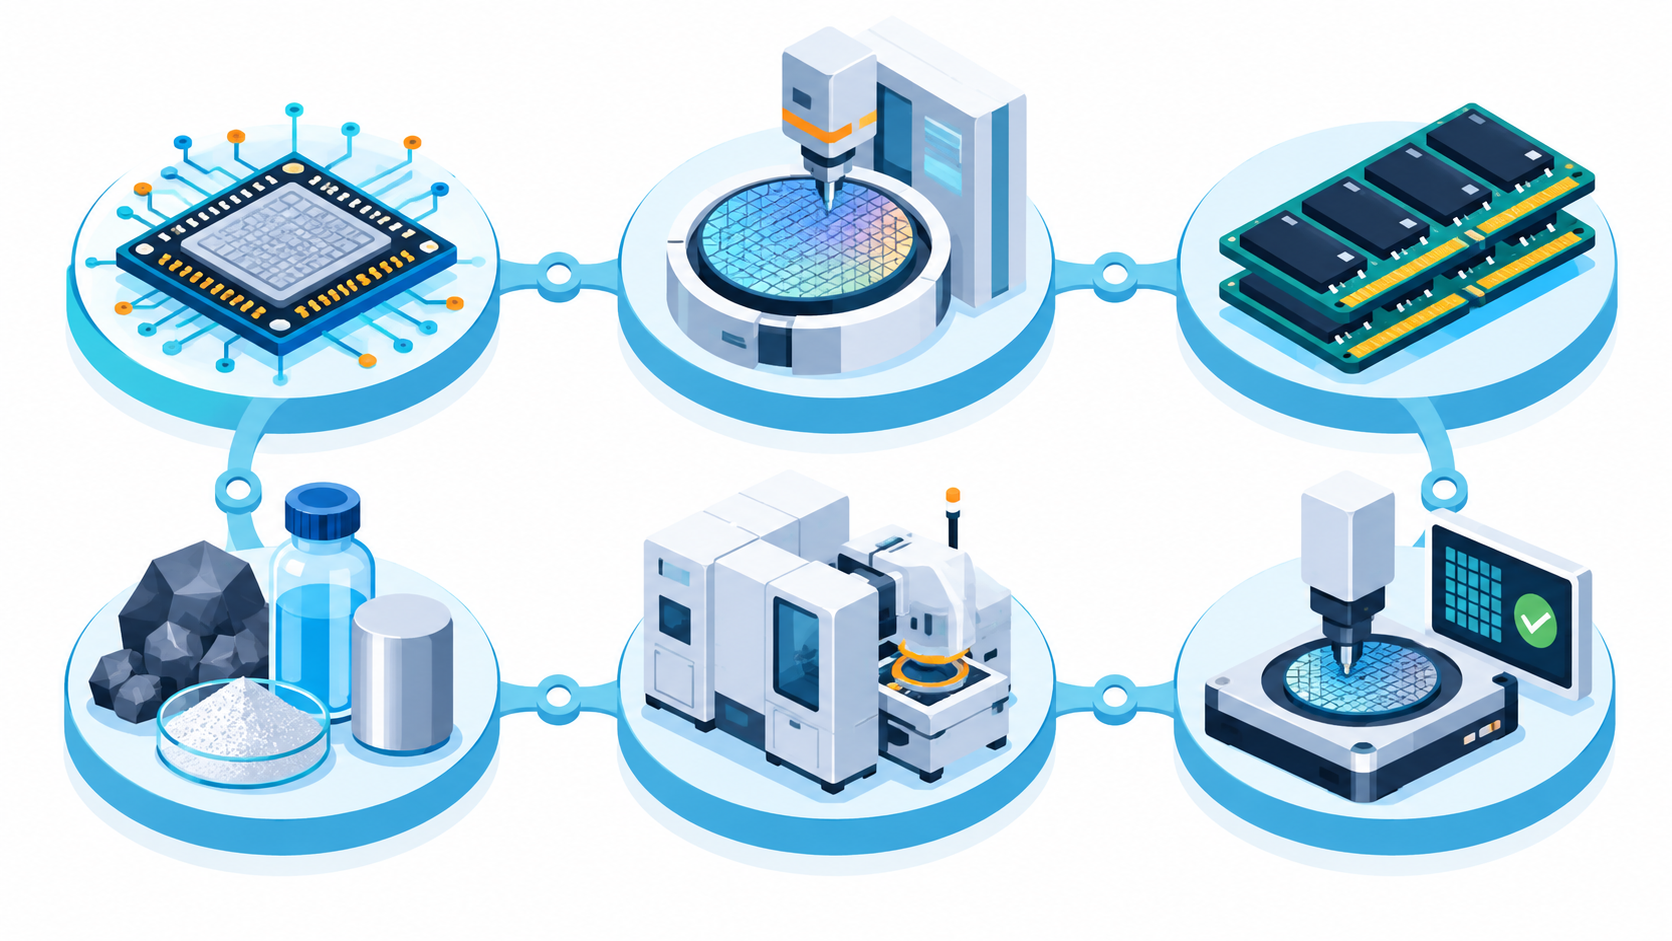
ここからは、AI半導体・計算資源の覇権候補として正式にノミネートした10社を、1社ずつ考察します。なお、並び順は優劣を意味しません。売上規模の大きさだけでなく、代替困難性という観点を特に重視して読んでくだされば幸いです。
NVIDIA(米国)|王者だが、称賛だけでは終われない
NVIDIAは、AI GPU・AI計算基盤・CUDAという3つの柱で、AI半導体サプライチェーンの「顔」を務める企業です。データセンター事業の売上は、直近の四半期決算(2026年7月26日終了)で890億ドルに達し、時価総額でも世界最大級の企業に数えられます。
ジェンスン・フアンCEOは、GPUという半導体単体の性能ではなく、CUDAというソフトウェア環境とサーバーラック全体を一体で提供する戦略を貫き、AI計算基盤という新しいカテゴリーそのものを作り上げました。
一方で、前章でも解説したように、NVIDIAの立ち位置は「支えられている王者」でもあります。最先端チップの製造はTSMCに、HBMはSK hynixやSamsung、Micronに、EUV露光装置を使う製造工程全体はASMLの技術なしには成立しません。
さらに、Google・Amazon・Microsoftといった巨大クラウド企業が、自社開発のAIチップ(TPU、Trainium、Maia等)への投資を積み増しており、社内の計算基盤の一部をNVIDIA以外へ置き換え始めています。AMDのInstinctシリーズも、大手AI企業向けの大型契約を獲得するなど、追い上げを見せています。
とはいえ、代替困難性という観点では、NVIDIAが作り上げたCUDAエコシステムそのものが最大の防波堤となるでしょう。仮にGPU単体の性能で追いつく競合が現れても、何百万人という開発者が積み上げてきたソフトウェア資産を、短期間で置き換えるのは容易ではありません。
ただし、大手クラウド企業が自社チップへ社内需要を移す動きは、長期的にはNVIDIAへの依存度を下げる要因になり得ます。AI需要そのものが拡大を続けるかぎり成長余地は大きい一方、その成長を支える製造能力・HBM供給・装置供給のどこかが詰まれば、NVIDIA自身の成長も制約を受けてしまうかもしれません。
最大の強みであるエコシステムの厚みと、最大の弱みである「自社では何も作れない」という構造が、同じ企業のなかに同居している。NVIDIAが「GAFAMの次」の最有力候補である理由は、規模と圧倒的なエコシステムの両方を同時に持つ企業がほかに見当たらないからです。
出典・参照:
AMD(米国)|「2番手」ではなく、別のAI計算基盤が成立するかという問い
AMDを単純に「NVIDIAの2番手」として片づけると、この企業の面白さを見落としかねません。問うべきは、NVIDIAともCUDAとも異なるAI計算基盤が、本当に市場として成立するのかという点です。
AMDはCPUのEPYCシリーズとAIアクセラレータのInstinctシリーズを両方自社設計し、NVIDIAのCUDAに対抗するソフトウェア環境としてROCmを整備してきました。データセンター事業の売上は2026年第1四半期に58億ドルとなり、前年同期比57%の増加を記録しています。
同社を率いるリサ・スーCEO(Lisa Su)は、次世代のInstinct MI400シリーズ(TSMCの先端プロセスを採用)を発表し、Metaとの間で最大6ギガワット規模のカスタムInstinct GPU供給契約、Anthropicとの間で最大2ギガワット規模のMI450供給および共同ソフトウェア開発契約を結んでいます。
AMDの強みは、GPUとCPUを両方手がける総合力と、大手AI企業から直接大型契約を獲得できる交渉力にあります。一方で、ROCmの開発者エコシステムは、CUDAの厚みに比べればまだ発展途上であり、AI開発者が学習・推論の環境をどこまでAMD向けへ移すかが今後の焦点になります。
代替困難性という点では、AMD自身が「NVIDIAの代替」を目指す立場にあり、自らが他社にとって代わりの利かない存在になれるかは、これからの実績次第という段階です。
しかし、AI需要の拡大がAMDにとっての追い風であることは間違いなく、MetaやAnthropicのような大口顧客を確保できたことは、成長余地の大きさを裏づけています。「GAFAMの次」の候補としては、NVIDIA一強の構図に実際にヒビを入れられるかどうかが試金石となるでしょう。
出典・参照:
Broadcom(米国)|汎用GPUではなく「専用チップ」という別ルート
Broadcomは、NVIDIAやAMDのような汎用GPUを作る企業ではありません。大手AI企業やクラウド企業の要望に応じて、その企業専用のAIチップ(カスタムASIC、業界ではXPUとも呼ばれます)を設計するという、別のルートでAI半導体市場に参入しています。
2026年9月2日に発表した四半期決算によれば、AI半導体事業の売上高は167億ドルで、前年同期比221%の増加を記録しました。ホック・タンCEO(Hock Tan)によれば、OpenAI・Google・Anthropicを含む6社の大手AIモデル開発企業とカスタムXPUの開発で協業しており、GoogleのTPU(Ironwood世代)の製造・出荷を加速させているほか、OpenAIと共同開発した「Jalapeno」チップも披露しています。
次の四半期のAI半導体売上は217億ドル(前年同期比236%増)まで拡大する見通しで、同社は2027年に1150億ドル、2028年に2300億ドルのAI関連売上を見込むと説明しています。
Broadcomの強みは、特定の巨大顧客ごとに最適化したチップを設計できる技術力と、AIネットワーキング(データセンター内でサーバー同士を高速接続する技術)を併せ持つ点にあります。汎用GPUを大量に売るNVIDIAと違い、顧客企業と深く入り込んだ設計を行うため、契約を獲得できれば代替が利きにくい関係を築きやすくなります。
一方で、顧客企業の数が限られる分、特定の大口顧客への依存度が高くなりやすいという弱みもあります。汎用GPUではなく、巨大企業専用のAIチップが普及していく流れが強まれば、NVIDIA一強という構図そのものが変わる可能性があります。
出典・参照:
Arm(英国)|作らないのに、設計思想を握る企業
Armは、自ら半導体を製造しない点ではNVIDIAと同じですが、GPUやCPUの完成品を自ら売ることもしません。Armが握っているのは、CPUの基本設計(アーキテクチャ)と、それを利用するためのライセンスという、さらに上流の資産です。本社は英国ケンブリッジにあり、親会社は日本のソフトバンクグループで、株式は米ナスダックに上場しています。
世界中のスマートフォン向けCPUの大半がArmのアーキテクチャを採用してきましたが、近年はデータセンター向けのArmベースCPU(Neoverse)の採用が広がっています。直近の四半期決算では売上高が12.9億ドルで前年同期比22.4%増となり、データセンター向けのロイヤリティ収入は前年同期比で2倍以上に伸び、Neoverseの累計出荷コア数は15億個を超えました。
レネ・ハースCEO(Rene Haas)は、従来のライセンス収入に加えて、Meta等と共同で自らAI向けCPU(AGI CPU)を設計・展開する事業へも踏み出しており、今後5年でこの自社設計チップの収益がライセンス収入を上回るという見通しを示しています。
Armの代替困難性は独特です。個々のCPU設計そのものは他のアーキテクチャ(x86やRISC-V等)で代替できる部分もありますが、長年にわたって蓄積されたソフトウェア資産と、省電力設計に対する信頼は簡単には置き換えられません。
ただし、Arm自身がライセンス提供者から自社チップメーカーへと踏み出すことは、これまでArmのライセンスを使ってきた顧客企業と競合関係になるリスクもはらみます。「作らないのに設計思想を握る」という立ち位置そのものが、いままさに変化しつつあるようです。
出典・参照:
TSMC(台湾)|誰が勝っても、製造を握れば真の勝者
NVIDIAが勝っても、AMDが勝っても、カスタムASICが伸びても、最先端チップの多くはTSMCの工場で作られます。この構造こそ、TSMCを今回の企画で最も象徴的な企業にしているゆえんです。
C.C.ウェイ会長兼CEO(C.C. Wei)が率いるTSMCは、2026年4〜6月期の世界ファウンドリー(半導体受託製造)市場で、調査会社の集計により72〜73%程度のシェアを占め、2位のSamsungとの差はさらに広がっています。AI半導体の性能を左右する先端パッケージング技術CoWoSの月産能力を、2024年末の約3.5万枚から2026年末には約13万枚まで、4倍近くに拡大する計画を進めていますが、それでも需要には追いついていないと、ウェイCEO自身が説明しています。
TSMCの最大の強みは、最先端プロセスと先端パッケージングを同時に提供できる、他に代わりのいない製造能力そのものにあります。一方で最大のリスクは、台湾をめぐる地政学リスクです。
米国アリゾナ州(3nmプロセスを含む複数工場、総投資額は約400億ドル規模)、日本の熊本(第2工場で3nmプロセスの国内量産を計画、投資規模は170億ドル程度)など、海外生産拠点の拡大を進めていますが、最先端プロセスの大部分は依然として台湾国内に集中しています。
本企画では、その是非を問うことはしませんが、中国と台湾の緊張関係は、次世代覇権を占う上で無視のできない事実であるのは間違いありません。この地政学リスクをどう読むかは、AI半導体サプライチェーン全体にとって最大の不確実性の1つです。
出典・参照:
ASML(オランダ)|「売上規模より代替困難性」を体現する企業
ASMLは、今回の企画のテーマそのものを象徴する企業です。売上規模ではNVIDIAやTSMCに及びませんが、この企業が止まれば、最先端の半導体そのものが世界のどこでも作れなくなります。
ASMLは、EUV(極端紫外線)という特殊な光を使う露光装置を、世界で唯一量産できる企業です。EUV装置がなければ、微細な回路を刻むことができません。クリストフ・フーケCEO(Christophe Fouquet)のもとで、同社は2026年に入ってからの決算で通期の売上高見通しを段階的に引き上げており、直近では430億から450億ユーロとしています。AI投資にともなう旺盛な受注が背景にあり、2025年末時点の受注残高は388億ユーロに達していました。次世代機のHigh-NA EUVの出荷も始まっており、EUV関連の売上は全体の6割超を占めています。
ASMLの代替困難性は、正式ノミネート10社のなかでも際立って高いといえます。EUV露光技術は、光学・精密機械・材料科学が極限まで組み合わさった技術であり、競合する企業がゼロから開発しようとしても、数十年単位の時間と莫大な投資が必要になります。
弱みを挙げるとすれば、需要が旺盛すぎるがゆえに供給が追いつかず、TSMCやSamsungといった顧客企業の生産計画そのものを左右してしまう立場にあることです。NVIDIAより企業規模は小さく見えても、そこが止まれば産業全体が止まるという意味で、ASMLは「ボトルネック支配」という今回のテーマを最も分かりやすく体現しています。
出典・参照:
SK hynix(韓国)|GPUの性能を引き出す「データの通り道」
GPUがどれほど速く計算できても、計算対象のデータを高速に受け渡せなければ意味がありません。この役割を担うHBM(広帯域メモリ)市場で、長年高いシェアを維持してきたのがSK hynixです。
クァク・ノジョンCEO(Kwak Noh-jung)のもとで、SK hynixは市場調査各社の推計によれば、時期により5〜6割程度のHBM市場シェアを維持しているとされ、次世代のHBM4Eのサンプル完成を2026年内に、量産開始を2027年に見込んでいます。同社は、2027年をメモリ業界史上最も深刻な供給不足の年になると予測しており、AIサーバー需要の拡大が、供給能力を上回るペースで続くとみています。
SK hynixの強みは、HBMという特殊なメモリで先行者としての技術蓄積を積み上げてきたことにあります。HBMは複数のメモリチップを垂直に積層して接続する構造を持ち、通常のメモリより製造難易度が高くなります。一方で、SamsungやMicronが猛追しており、なかでもMicronは2026年第2四半期時点でシェア18%程度まで伸ばしてきたとの調査もあります。
代替困難性という点では、HBM市場全体が数社の寡占状態にあるためSK hynix1社が完全に置き換え不能というわけではありませんが、NVIDIAをはじめとするGPUメーカーとの緊密な擦り合わせ開発の関係は、簡単には他社へ移し替えられません。
出典・参照:
Samsung Electronics(韓国)|一社で複数レイヤーを握る総合力
Samsung Electronicsの特徴は、メモリ・HBM・ファウンドリー(受託製造)・先端パッケージングという、AI半導体サプライチェーンの複数のレイヤーを1社で持っている点にあります。SK hynixがHBMに特化して強さを発揮するのに対し、Samsungは幅広さで勝負する構造です。
半導体部門(DS部門)を率いるジョン・ヨンヒョン(Jun Young-hyun)副会長のもとで、Samsungは2026年のHBM売上高が前年比で3倍以上に伸びる見通しを示し、次世代のHBM4Eおよび将来世代のHBM5のアーキテクチャも公開しています。2026年3月には、設備投資と研究開発に110兆ウォン(約733億ドル)を投じる計画を発表しました。
Samsungの強みは、メモリとファウンドリーの両方を持つことで、他社にはできない一体型の提案ができる点にあります。一方で、ファウンドリー事業の世界シェアはTSMCに大きく水をあけられており、HBM市場でもSK hynixの後を追ってきた歴史があります。
この構造は、いわば複数のレイヤーで「2番手」に位置しているともいえ、各分野で単独トップに立てるかどうかが、Samsungの今後の代替困難性を左右します。
出典・参照:
東京エレクトロン(日本)|「日本期待枠」ではなく世界の正式ノミネート
東京エレクトロンは、日本企業だからという理由で編集部がノミネートに選んだわけではありません。半導体製造装置という領域で、世界のAI半導体作りに不可欠な存在として選びました。
河合利樹社長兼CEOが率いる東京エレクトロンは、フォトレジスト(感光材)を塗布・現像する装置(コータ・デベロッパ)で世界シェア9割超を持つと、同社自身の投資家向け資料で説明しています。このほか、エッチング装置で2割強、成膜装置で3割弱、洗浄装置で2割程度のシェアを持つとされ、単一工程ではなく複数の工程で高い競争力を維持している点が特徴です。
日本半導体製造装置協会(SEAJ)の予測では、2026年度の日本製半導体製造装置の販売額は前年度比12%増の5兆5004億円に達する見通しで、SEAJ会長でもある河合氏は「先端品の割合が高まっており、日本製装置の世界シェアが伸びる可能性は高い」と述べています。
東京エレクトロンの強みは、複数の重要工程で高いシェアを持つ総合力にあります。1つの装置が止まっても他社製品で代替できる工程がある一方、コータ・デベロッパのように9割超のシェアを持つ工程では、事実上の代替先がありません。
弱みとしては、中国メーカーが政府支援を受けて追い上げており、同社自身も技術世代を先行させ続けることでしか優位性を守れないという緊張関係が続いています。世界のAI半導体を作るために、日本企業の装置が必要になっているという構造は、地味に見えて極めて強固なものです。
出典・参照:
Advantest(日本)|サプライチェーン最後のボトルネック
Advantestも、日本枠ではなく世界の正式覇権候補として扱うべき企業です。最先端のAI半導体を設計・製造できても、それが正しく動くことを確認できなければ、商品として出荷できません。この「最後の関門」を担うのがAdvantestです。
同社は2024年4月から、ダグラス・ラフィーバ氏(Douglas Lefever)がグループCEO、津久井幸一氏が社長兼グループCOOという体制で経営にあたっています。AI・HPC(高性能計算)向け半導体は、回路の複雑化にともなってテストにかかる時間と精度への要求が飛躍的に高まっており、同社はAI・HPC向けの次世代テスタ、3次元パッケージング対応技術、AIを使ったデータ解析機能への研究開発投資を重点分野に据えています。
Advantestの強みは、AI・HPC向けの複雑なテストという領域で技術的な優位を確立してきたことにあります。半導体テスト市場自体は景気変動の影響を受けやすいものの、AI半導体は従来の民生用半導体よりテストの難易度が段違いに高く、この分野に特化した投資が功を奏しています。
米国のTeradyneという競合は存在するものの、最先端AI・HPC向けテスタという領域では代替が利きにくい立ち位置を築いてきました。設計・製造・パッケージングのすべてが完璧でも、テストで不良を見逃せば製品にはなりません。この「最後の1工程」を握っていることこそが、Advantestの覇権候補たるゆえんです。
出典・参照:
執筆者
DXportal®運営チーム
DXportal®編集部
DXportal®の企画・運営を担当。デジタルトランスフォーメーション(DX)について企業経営者・DX推進担当の方々が読みたくなるような記事を日々更新中です。掲載希望の方は遠慮なくお問い合わせください。掲載希望・その他お問い合わせも随時受付中。